【中国又一个DeepSeek时刻到了】这次扛大旗的是月之暗面,它在凌晨发布了Kimi K3,震惊了全球科技界。
7月17日凌晨,月之暗面把Kimi K3扔了出来,2.8万亿参数,100万上下文窗口,原生多模态,这不是一次常规的版本迭代,而是一颗直接砸进全球AI圈的重磅炸弹。
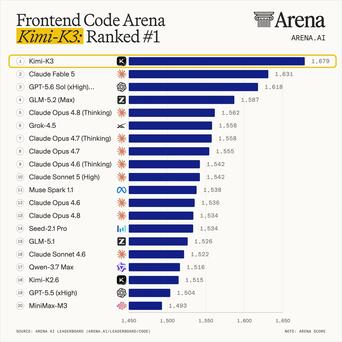
发布不到一天,Kimi K3就以1679分登顶Arena AI前端代码竞技场,超过了Anthropic的Claude Fable 5的1631分和OpenAI的GPT-5.6 Sol的1618分。
而就在这份榜单发布前,月之暗面的上一代模型K2.6,排名大约是第十八位。一代产品,跳了整整17个名次。
不少美国科技界人士的感叹很有意思。美国科技媒体Axios的报道标题相当直接——“Kimi新模型的性能让AI世界感到震惊”。
Axios特别提到,K3在Arena的盲测中,开发者在前端编程任务上对它的偏好超过了多款美国主流模型,而整个中国AI行业“正以月为单位缩小与美国的差距”,为什么一个中国创业公司的开源模型,能让硅谷这么慌?
先看体量。2.8万亿总参数,是目前全球参数最大的开源模型,也是全球首个3万亿级别的开源大模型。
此前的DeepSeek V4总参数是1.6万亿,文心大模型5.0是2.4万亿。按月之暗面自己的说法,过去十二个月里,有九个月,开源模型的尺寸上限都是Kimi在守。
参数大不等于能力强,这个道理圈内人都懂。但K3不只是堆参数。它基于自研的KDA混合线性注意力机制和注意力残差技术构建。
在百万级token场景下能实现最高6.3倍的解码加速,用不到2%的额外成本换取约25%的训练效率提升。月之暗面给了一笔总账:同样的算力,K3把它变成智能的效率,是上一代的2.5倍。
K3的实际能力在案例里展现得更直观。官方展示了一个科研编程案例:K3用大约两小时,完成了通常需要资深研究人员一到两周才能做完的工作。
复现计算天体物理领域的I-Love-Q普适关系,阅读并交叉验证了20多篇论文,评估了300多种状态方程,最终生成3000多行Python代码。另一个案例中,它在连续48小时的自主运行中独立完成了一款芯片的构建、优化与验证。
这才是让美国圈内人真正紧张的东西。中国AI不再只是“参数大、便宜”,而是开始在一些关键能力上直接对标甚至超越美国最强闭源模型。K3综合能力仍落后于Fable 5和GPT-5.6 Sol,但在整套评测中稳定超过GPT-5.5和Opus 4.8。
更值得注意的是定价。K3的API输出定价为每百万token100元人民币(约15美元),与Anthropic Sonnet 5完全相同。
Axios注意到,这一价格低于K3正在挑战的多款美国高端模型,引发了一个让硅谷睡不着的问题:当中国企业不断以更低成本提供前沿模型时,美国AI公司还能以高价销售相关服务多久?
估值层面的冲击同样惊人。月之暗面最新估值约为315亿美元,而Anthropic和OpenAI在最新一轮融资中的估值已分别达到9650亿美元和8520亿美元。如果算力堆叠的成本优势被技术效率抹平,美国巨头的估值模型就得从头算一遍。
Jefferies在7月13日的报告中提到,中国模型的全部估值逻辑都隐含着“能力差距持续收窄”的前提,而K3的发布某种程度上抵消了“能力差距拉大”的判断。
更值得关注的是整个赛道的连锁反应。K3权重将于7月27日开放,届时开发者可以自由下载和部署。此前美国已暂停向外国用户开放Anthropic的Fable等模型,中国开源模型正好卡在这个时间窗口。
K3登顶这件事,本质上是一个算力效率的悖论被彻底验证了。美国AI公司过去几年的叙事逻辑是“算力堆叠等于智能进步”,谁融的钱多、买的卡多,谁就是王者。
但K3用不到对手三分之一的估值和远低于对手的算力,做出了能登顶前端代码榜的模型——这条路径证明,智能进步不一定非得靠烧钱堆卡,算法创新和工程效率同样能打出翻身仗。
当然,也要泼一盆冷水。代码榜登顶不等于全面超越,K3的综合能力仍落后于最强的闭源模型,月之暗面自己也坦承“仍有提升空间”。
但另一个观察是,K3的定价策略明显在往上走,不再走“白菜价”路线,这意味着它要在性能上真正坐稳第一梯队的位置,才能撑得起这个价格。
对于关注AI的普通用户来说,K3带来的改变其实很具体:以后写代码、剪视频、做研究,可能不再需要花大价钱买美国顶级模型了。
一个开源的、价格和对手齐平的国产模型,在部分任务上就能干得更好。这才是“DeepSeek时刻”真正的含义——不只是技术登顶,而是中国AI开始在全球定价权上有了话语权。
富华优配提示:文章来自网络,不代表本站观点。